블로그
-
[ML] Beyond Text: Optimizing RAG with Multimodal Inputs for Industrial Applications (PR-284)
Multimodal RAG의 가능성을 보여준 이 논문은 텍스트와 이미지를 처리하는 Multimodal RAG 시스템을 실험해 산업 도메인에서 성능 향상을 분석했습니다. Multimodal 입력을 사용한 RAG 모델은 문서 요약 및 질의응답과 같은 태스크에서 텍스트 전용 RAG 모델보다 우수한 성과를 보였습니다.
blog.naver.com · 2024.11.06

-
[ML] Multimodal RAG over Market Research Reports (LlamaCloud)
의미론적으로 이해하여 관련 페이지를 검색할 수 있는 advanced indexing/retrieval algorithms과 주어진 페이지 내의 모든 콘텐츠를 이해해야 하는 multimodal LlamaCloud를 사용하면 몇 분 안에 multimodal RAG pipeline을 설정하고 복잡한 막대/선/파이 차트 분석에 대한 질문에 답할 수 있습니다.
blog.naver.com · 2024.10.01
-
[ML] Multimodal RAG over Market Research Reports (LlamaCloud)
의미론적으로 이해하여 관련 페이지를 검색할 수 있는 advanced indexing/retrieval algorithms과 주어진 페이지 내의 모든 콘텐츠를 이해해야 하는 multimodal LlamaCloud를 사용하면 몇 분 안에 multimodal RAG pipeline을 설정하고 복잡한 막대/선/파이 차트 분석에 대한 질문에 답할 수 있습니다.
blog.naver.com · 2024.10.01
-
[ML] Multimodal RAG in LlamaCloud (Jerry Liu)
멀티모달 파이프라인은 이미지를 텍스트로 추출할 뿐만 아니라 텍스트 청크와 함께 인덱싱된 기본 이미지 청크도 저장합니다. 이를 통해 LLM은 합성 단계에서 검색된 텍스트와 이미지를 모두 입력으로 사용할 수 있습니다. LlamaCloud의 새로운 멀티모달 기능을 사용하면 몇 분 안에 완전한
blog.naver.com · 2024.09.18
-
[ML] Multimodal RAG in LlamaCloud (Jerry Liu)
멀티모달 파이프라인은 이미지를 텍스트로 추출할 뿐만 아니라 텍스트 청크와 함께 인덱싱된 기본 이미지 청크도 저장합니다. 이를 통해 LLM은 합성 단계에서 검색된 텍스트와 이미지를 모두 입력으로 사용할 수 있습니다. LlamaCloud의 새로운 멀티모달 기능을 사용하면 몇 분 안에 완전한
blog.naver.com · 2024.09.18

-
[ML] How to Fine-Tune Multimodal Models or VLMs with Hugging Face TRL (Philschmid)
오픈 multimodal LLM과 VLM을 미세 조정하는 가장 좋은 방법은 무엇인가요? 개방형 multimodal LLM은 최근 Meta AI의 Llama 3.2 Vision, Mistral AI의 Pixtral, Qwen 2 VL, Allen AI의 Molmo 등 엄청난
blog.naver.com · 2024.10.01
-
[ML] How to Fine-Tune Multimodal Models or VLMs with Hugging Face TRL (Philschmid)
오픈 multimodal LLM과 VLM을 미세 조정하는 가장 좋은 방법은 무엇인가요? 개방형 multimodal LLM은 최근 Meta AI의 Llama 3.2 Vision, Mistral AI의 Pixtral, Qwen 2 VL, Allen AI의 Molmo 등 엄청난
blog.naver.com · 2024.10.01
-
Multi-modal chromatography를 사용한 pDNA 정제법
오늘은 multimodal chromatography를 사용한 pDNA 정제 방법에 대해서 간단히 소개해드리도록 하겠습니다! Multimodal chromatography란, 쉽게 말해서 2가지 이상의 방법으로 타깃 물질을 binding 할 수 있는 방법으로, 이전에 전통적으로 사용된 affinity chromatographyh
blog.naver.com · 2024.08.11
-
[ML] Llama 3.2: Revolutionizing edge AI and vision with open, customizable models (PR-279)
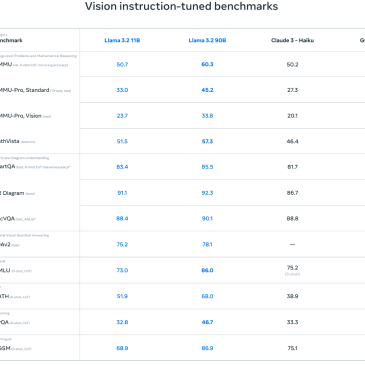
TL;DR: Llama 3.2 Vision: 11억 개의 이미지 텍스트 쌍으로 학습된 Llama 3.1 텍스트 모델을 기반으로 한 90B 및 60B 크기의 Multimodal(텍스트
blog.naver.com · 2024.09.29
-
[ML] Llama 3.2: Revolutionizing edge AI and vision with open, customizable models (PR-279)
TL;DR: Llama 3.2 Vision: 11억 개의 이미지 텍스트 쌍으로 학습된 Llama 3.1 텍스트 모델을 기반으로 한 90B 및 60B 크기의 Multimodal(텍스트
blog.naver.com · 2024.09.29